AES 分组长度固定为 16 字节,敏感数据超过一个分组怎么办?
AES 只规定了一块多大,却没有替你决定数据该怎样排队。
软考题目问:AES 的固定分组长度为 16 字节,用户个人信息、位置信息等敏感数据超过一个分组时,应如何安全处理?这道题考的不是把字符串硬切成 16 字节,而是:分组密码本身只能吃一块,真正决定安全的是工作模式、随机参数和完整性保护。
很多答法直接甩「用 GCM」。能得分,但容易把「AES 算法」和「AES 的使用方式」糊成一件事。下面先把 AES 本身说清楚,再看它缺什么,最后落到 GCM 等变体怎么补洞。
先给出 300 字以内的答法
应采用经验证的分组密码工作模式处理多分组数据,例如 AES-GCM(优先)或 AES-CTR 配合 HMAC。加密时为每条消息生成不可预测且不重复的随机 nonce/IV;明文按模式自动分组,最后一组不足 16 字节由模式处理,不应自行补零后直接拼接。密钥应由安全的密钥管理系统生成、保存和轮换,不能硬编码。解密前先校验认证标签(或 HMAC),校验失败立即丢弃,防止篡改和填充预言机攻击。nonce、认证标签和必要的版本号可与密文一起存储,但不得泄露密钥。ECB 模式会泄露重复块的模式,不能用于此类敏感信息。
AES 到底在算什么
AES(Advanced Encryption Standard)是 NIST 选定的对称分组密码,算法出身是比利时人设计的 Rijndael。对称的意思很直白:加密和解密用同一把密钥;分组的意思同样直白:它一次只吃固定长度的输入。
按 FIPS 197:
- 分组长度固定 128 bit,也就是 16 字节。这就是题干里那个数字的来源。
- 密钥长度可选 128 / 192 / 256 bit,对应常见说法 AES-128、AES-192、AES-256。
- 轮数随密钥变长而增加:分别是 10 / 12 / 14 轮。
为什么偏偏是 16 字节
16 字节不是业务层随便拍的,也不是“AES 算力不够所以只能切这么短”。它是 NIST 征集 AES 时的硬性要求:候选算法至少要支持 128 bit 分组,密钥再覆盖 128 / 192 / 256 bit。后来入选的 Rijndael 其实还能做 192、256 bit 分组,但写进 FIPS 197 时,块长被定死为 128 bit;名字后面的数字只表示密钥长度,不表示块长。
为什么要从 DES 的 64 bit 往上翻一倍?核心是 生日界(birthday bound)。
分组密码在 CBC 一类模式里,同一密钥下加密的块足够多时,密文块迟早会撞车;撞车会泄露两个明文块的异或关系。粗口径是:块长 \(n\) bit,大约加密 \(2^{n/2}\) 个块后,碰撞概率就变得不可忽视。
| 块长 | \(2^{n/2}\) 量级 | 直观后果 |
|---|---|---|
| DES / 3DES:64 bit | 约 \(2^{32}\) 块,几个 GB 量级 | 后来 Sweet32 证明,长连接里真能打 |
| AES:128 bit | 约 \(2^{64}\) 块 | 同一密钥下可安全处理的数据量远远更大 |
数字差一倍看起来不起眼,安全数据量却不是线性翻倍。下面这张示意把差距拉到肉眼可见的尺度(条形不是精确对数比例,只为建立直觉):
NIST 在 AES 研制回顾里也写得很直白:DES 的 64 bit 块长当时已经开始扛不住这类攻击,所以新标准把块长抬到 128 bit。实现上,128 bit 正好排成 4×4 字节状态矩阵,和字节级的 SubBytes、按行移位、按列混合很合拍,软硬件都好做。
状态矩阵长这样;ShiftRows 做完以后,同一行的字节会换列,颜色跟着字节走:
所以题干里的“16 字节”要拆成两层看:
- 设计层:128 bit 是为了摆脱 64 bit 块长的生日碰撞天花板,并统一成可高效实现的状态结构;
- 使用层:AES 仍然一次只吃一块。业务数据几乎总是长于 16 字节,于是“超过一个分组怎么办”就变成工作模式问题,而不是再发明一种更长块的 AES。
AES 采用的是 SPN(Substitution-Permutation Network,替换-置换网络),不是 DES 那种 Feistel 结构。状态被排成 4×4 的字节矩阵,每一轮大致做四件事:
| 步骤 | 人话 | 密码学目标 |
|---|---|---|
| SubBytes | 每个字节查 S-box 换成另一个字节 | 非线性混淆,打乱输入输出的代数关系 |
| ShiftRows | 按行循环移位 | 让字节在矩阵里换位置 |
| MixColumns | 按列做有限域上的线性混合 | 扩散:一处改动牵动整列 |
| AddRoundKey | 与本轮子密钥按位异或 | 把密钥材料灌进状态 |
四个步骤可以先记成一条流水线:先搅乱字节,再换位,再扩散整列,最后把本轮密钥灌进去。
首轮前会先做一次 AddRoundKey;最后一轮通常省略 MixColumns。密钥扩展(Key Schedule)则从主密钥派生出每一轮要用的轮密钥。整段加密就是把上面这一轮重复多遍:
这张图想说明一件事:AES 的「产品接口」极其克制——进 16 字节,出 16 字节。它不负责文件、JSON、用户资料行,也不负责“这段密文有没有被改过”。
工程上 AES 仍然很强:设计公开、审查充分、软件和硬件都成熟,现代 CPU 还有 AES-NI 一类指令。真正出问题的地方,往往不在轮函数公式,而在怎么拿它处理长数据。
AES 本身有哪些不足
这里说的“不足”,不是说 AES 已被攻破,而是单看算法原语时,它天然不管的事:
- 只会处理一块。 超过 16 字节,就必须叠加工作模式。自己按 16 字节切开、每块独立加密,等于默默退化成 ECB。
- 只提供机密性,不提供完整性。 AES 加密告诉你“别人看不懂”;它不保证“别人没改过密文”。敏感资料一旦可能被篡改、重放或拼贴,还需要 MAC 或 AEAD。
- 确定性函数。 同一密钥、同一明文块,结果永远一样。没有随机 IV/nonce 的包装,重复内容会在密文里露出轮廓。
- 实现细节会变成安全细节。 填充方式、错误回显、计时差异、nonce 管理,都会打开旁路。CBC 搭配可预测 padding 就容易撞上填充预言机;GCM 复用 nonce 则可能直接泄露密钥流相关信息。
- 量子计算会削弱对称密钥的有效强度。 粗口径是 Grover 搜索把有效密钥空间开方;实务上长期机密多用 AES-256,但日常业务数据更优先把模式和密钥管理做对。
所以题目里的“超过一个分组怎么办”,真正答案不是“再调一次 AES”,而是“选对工作模式,并把随机性和完整性一起配齐”。
工作模式:把一块 AES 变成能处理长数据的工具
工作模式规定三件事:多块之间怎么关联、最后一块不够 16 字节怎么办、要不要顺带做认证。先看 ECB / CBC / CTR 怎样把多个 16 字节块串起来,差异一眼就能对上后面的取舍:
ECB:看起来最简单,也最不该用
ECB(Electronic Codebook)对每个明文块独立加密。相同明文块 → 相同密文块。姓名字段、坐标结构、JSON 键值重复出现时,密文会把重复模式直接画出来。
用几何色块做个示意:左边是明文图案,中间按 ECB 思路逐块映射,右边换成链式处理。中间那张仍能看出色块轮廓,右边则打散了。
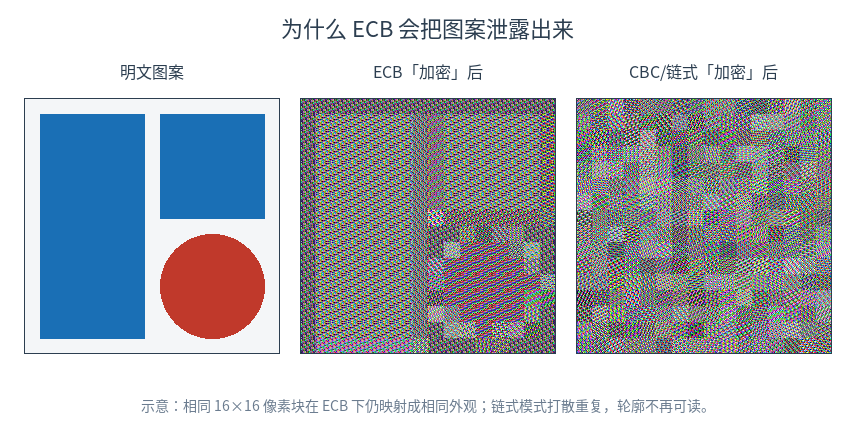
敏感个人信息、位置信息,直接排除 ECB。
CBC:链式加密,但完整性要另配
CBC(Cipher Block Chaining)加密第 \(i\) 块前,先把明文与前一块密文(第一块则与 IV)异或,再送进 AES。随机且不可预测的 IV,能打破 ECB 的“同明文同密文”。上图中间一栏已经画出了这条链:IV → ⊕ → AES → C1,再把 C1 喂给下一块。
也可以把依赖关系写成流程:
代价也很实在:
- 通常要填充到 16 字节整数倍,填充处理不当会引出 padding oracle;
- 解密可并行,加密有链式依赖;
- 仍然只有机密性。 工程上常见做法是 AES-CBC + HMAC(Encrypt-then-MAC),顺序不能搞反。
能用,但样板代码多、踩坑面大,新系统一般不再首选。
CTR:把分组密码变成流密码
CTR(Counter)用 AES 加密“nonce + 计数器”,得到密钥流,再与明文异或。加解密对称,可并行,天然不需要填充,任意长度明文都能处理。对应前面总览图的第三栏,以及下面这条更短的链路:
它解决了“超过 16 字节怎么切”的问题,但:
- nonce 绝对不能在同一密钥下复用,否则密钥流重复,明文可被异或抵消分析;
- 同样不自带完整性。实务里常见组合是 AES-CTR + HMAC。
GCM:现在默认该想到的答案
GCM(Galois/Counter Mode)在 NIST SP 800-38D 里标准化。它本质是两件事捆在一起:
- CTR 负责机密性:生成密钥流异或明文;
- GHASH(伽罗瓦域上的通用哈希)负责认证:对密文和可选的 AAD(Associated Data,附加认证数据)算出认证标签 tag。
因此 GCM 属于 AEAD(Authenticated Encryption with Associated Data):一次调用同时拿到机密性和完整性,还能绑定“不加密但要防篡改”的头信息,例如版本号、用户 ID、算法标识。
相对 CBC / 裸 CTR,GCM 的工程优势很具体:
- 一个 API 同时加密和验签,少一次“忘了配 HMAC”的事故;
- 不用 PKCS#7 那套填充,长度处理更干净;
- 可并行、硬件友好,TLS、HTTP/3、磁盘加密、云 KMS 里都很常见;
- 支持 AAD,密文和业务元数据可以绑死。
它也有硬约束:
- 同一密钥下 nonce 不可复用。 推荐 12 字节随机 nonce,或计数器式唯一 nonce;
- tag 要足够长,常见 16 字节;
- 解密时必须先验 tag,失败立即丢弃,不要把“半解密明文”吐给业务层。
同类 AEAD 还有 AES-CCM,以及非 AES 路线的 ChaCha20-Poly1305。没有 AES-NI 的移动端或某些嵌入式场景,ChaCha20-Poly1305 有时更香;服务器侧有硬件加速时,AES-GCM 通常是默认选项。
一张对照表
| 模式 | 机密性 | 完整性 | 填充 | 关键风险 | 现在怎么选 |
|---|---|---|---|---|---|
| ECB | 有,但会泄露模式 | 无 | 要 | 同块同密文 | 不要用 |
| CBC | 有 | 无,需另配 MAC | 要 | IV/填充预言机 | 遗留系统可维持 |
| CTR | 有 | 无,需另配 MAC | 不要 | nonce 复用 | 可作 AEAD 拼装件 |
| GCM | 有 | 有(AEAD) | 不要 | nonce 复用 | 新系统优先 |
回到软考题:个人信息、位置信息超过一个分组,正确答案的骨架就是——用 GCM(或 CTR+HMAC)这类已验证模式,而不是手工切块反复调用 AES。
一条可落地的数据路径
可以把密文记录设计成:版本号 | 算法标识 | nonce | ciphertext | tag。服务端从密钥管理系统取到密钥后生成 nonce,调用成熟密码库完成加密;读取时先验证 tag,再把明文交给业务逻辑。日志、缓存、异常堆栈也要避免把明文带出去,密钥轮换则通过版本号支持平滑迁移。
Python 里用密码库时,形态大致如下(示意,密钥仍应来自 KMS):
from Crypto.Cipher import AES
from Crypto.Random import get_random_bytes

def encrypt_gcm(plaintext: bytes, key: bytes, aad: bytes = b"") -> bytes:
    nonce = get_random_bytes(12)
    cipher = AES.new(key, AES.MODE_GCM, nonce=nonce)
    cipher.update(aad)
    ciphertext, tag = cipher.encrypt_and_digest(plaintext)
    return nonce + tag + ciphertext

def decrypt_gcm(blob: bytes, key: bytes, aad: bytes = b"") -> bytes:
    nonce, tag, ciphertext = blob[:12], blob[12:28], blob[28:]
    cipher = AES.new(key, AES.MODE_GCM, nonce=nonce)
    cipher.update(aad)
    return cipher.decrypt_and_verify(ciphertext, tag)
站内另一篇 Web 安全:加密、认证与授权 也写过 GCM 示例和密钥管理;那边偏 Web 全景,这里更关心 AES 原语和工作模式本身。
这道题真正想提醒什么
16 字节是 AES 算法接口的边界,不是业务数据的长度上限。AES 的轮函数负责把一块明文搅乱成一块密文;超过一块之后的安全性,来自正确的模式、唯一的 nonce、可靠的密钥管理和解密前的完整性校验。 四件事缺一,都可能让“已经 AES 加密”变成心理安慰。
下次再看到“分组长度固定为 16 字节怎么办”,先别急着切字符串。先问:用的是哪一种模式?有没有认证?nonce 会不会撞车?
参考资料
- NIST, FIPS 197: Advanced Encryption Standard (AES)
- NIST, SP 800-38D: Galois/Counter Mode (GCM) and GMAC
- NIST, Development of the Advanced Encryption Standard(含块长从 64 bit 抬到 128 bit 的背景)
- NIST, IR 8319: Review of the Advanced Encryption Standard(提到 64 bit 块长与 Sweet32)
- IETF, RFC 5116: An Interface and Algorithms for Authenticated Encryption
- Avi Kak, Lecture 8: AES
版权声明: 本文首发于 指尖魔法屋-AES 分组长度固定为 16 字节,敏感数据超过一个分组怎么办?(https://blog.thinkmoon.cn/post/1000-aes-block-size-sensitive-data/) 转载或引用必须申明原指尖魔法屋来源及源地址!
评论
使用 GitHub 账号登录后即可留言,支持 Markdown。